Showing Posts From
本地部署
-
 Brody
- 2026/08/05
不用花钱订阅AI绘画,我开始尝试本地部署文生图模型了|Flux 2.0 + Draw Things 体验
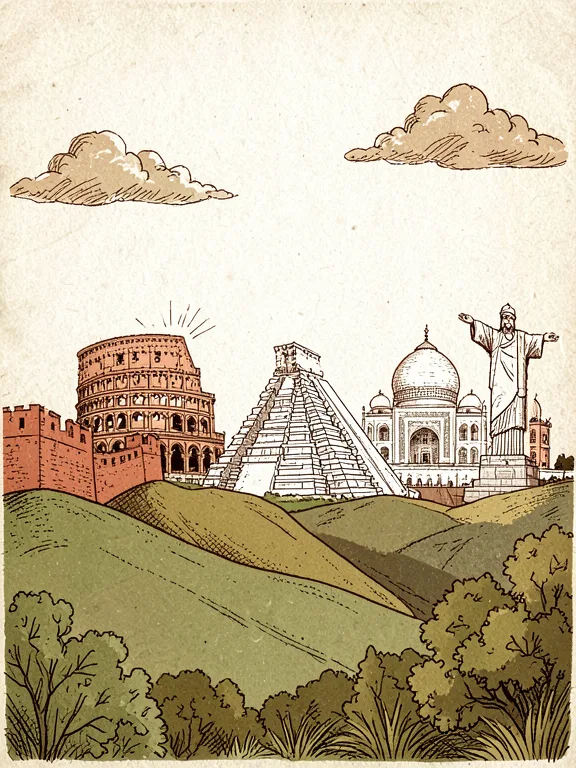
最近几年,AI 绘画的发展速度真的有点夸张。 从最开始需要复杂的提示词,到现在各种在线产品已经可以直接生成电影海报、产品图、插画,效果越来越接近专业设计师的工作流。 像 Midjourney、即梦、Higgsfield 这些在线产品,现在的体验已经非常成熟,打开网页输入一句话,很快就能得到高质量图片。 但是在体验这些工具的时候,我一直有一个想法: 如果未来 AI 创作成为一种基础能力,我们是不是应该拥有属于自己的本地 AI 工具? 所以最近开始尝试一些可以免费部署的小模型。 今天体验的是 Draw Things + Flux 2.0 模型。 Draw Things 是一个可以在本地运行 Stable Diffusion、Flux 等模型的 AI 绘图工具,支持 Mac、iPhone、iPad 等设备。 这次使用 Flux 2.0 生成了一组手绘插画风格图片。这次生成的成果 这是我用 Draw Things + Flux 2.0 生成的一张世界地标插画:整体效果让我有点惊喜。尤其是在这些细节上: ✅ 木刻版画那种不规则的线条感 ✅ 老式旅行海报的复古色彩 ✅ 手绘插画中的纸张纹理 ✅ 素描和版画结合的艺术效果 虽然和一些顶级在线模型相比,在理解复杂场景、人物细节方面还有差距,但是对于这种风格化创作,本地模型已经完全可以满足很多需求。Draw Things 是什么? Draw Things 是一款完全免费、开源的本地 AI 绘图应用,专门为 Apple 设备优化(Mac、iPhone、iPad)。它本质上是一个 Stable Diffusion / Flux 模型的 GUI 客户端。 核心特点特点 说明完全免费 无需订阅,无次数限制本地运行 所有计算都在你的设备上,数据不上传云端支持多种模型 Stable Diffusion 1.5/SDXL、Flux.1/2.0 等Apple Silicon 优化 针对 M1/M2/M3/M4 芯片做了深度优化跨设备同步 Mac、iPhone、iPad 可以共享模型和工作流Flux 2.0 是什么? Flux 是由 Black Forest Labs(前 Stability AI 核心团队)开发的下一代开源图像生成模型。Flux 2.0 [klein] 4B 是其精简版本——只有 40 亿参数,但在风格化创作、文本理解方面已经非常接近顶级闭源模型。💡 Draw Things 的中文界面非常友好,左侧可以选择模型(基本设置)、调节 LoRA、强度等参数,中间是画布,右侧是历史记录和工具。下面是我实际操作时的界面截图:可以看到我正在使用 FLUX.2 [klein] 4B (8-bit S) 模型生成一张乞力马扎罗山和维多利亚瀑布的复古旅行海报。完整的提示词分享 为了在 Draw Things 中重现这种风格,我构建了一个详细的提示词。这种风格结合了手绘素描、复古版画纹理和低饱和度的泥土配色。 提示词(Prompt) 你可以直接复制以下英文提示词到 Draw Things 的提示词输入框中:Hand-drawn illustration, vintage woodblock print texture, sketch-style art, printed on aged, textured cream-colored paper with visible fibers and grain. A world landmark collage panorama featuring, from left: a section of terracotta-colored Great Wall fortifications, the Colosseum in Rome, a white Mayan-style step pyramid, the Taj Mahal, and the Christ the Redeemer statue. The landmarks are arranged across rolling olive-green and brown hills, with stylized bushes and trees in the foreground. The sky is a large expanse of the textured paper with a few sketched, fluffy brown clouds. The color palette is muted and earthy: terracotta, olive green, muted gold, and off-white. All elements have irregular, dark brown ink lines with some stippling and cross-hatching textures. Small radiating light lines emanate from the tops of the Colosseum and the Taj Mahal. Nostalgic, educational, handcrafted travel poster aesthetic, intricate detail, high resolution, vector illustration style with organic textures.提示词详解 为了帮助你理解并根据需要进行微调,以下是提示词的详细解析:风格与纹理 (Style & Texture): Hand-drawn illustration, vintage woodblock print texture, sketch-style art(手绘插画,复古木刻版画纹理,素描风格艺术)。这是核心。 纸张背景 (Paper Background): printed on aged, textured cream-colored paper with visible fibers and grain(印在带有明显纤维和纹理的陈旧米色纸张上)。这决定了图像的基础质感。 主体内容 (Subject Matter): World landmark collage panorama featuring, from left: a section of terracotta-colored Great Wall fortifications, the Colosseum in Rome, a white Mayan-style step pyramid, the Taj Mahal, and the Christ the Redeemer statue.(世界地标建筑拼贴全景,从左起依次为:赤陶土色的长城城墙、罗马斗兽场、白色的玛雅式阶梯金字塔、泰姬陵和救世主基督像)。明确了具体元素和位置。 场景与构图 (Scene & Composition): Arranged across rolling olive-green and brown hills, with stylized bushes and trees in the foreground. The sky is a large expanse of the textured paper with a few sketched, fluffy brown clouds.(排列在连绵起伏的橄榄绿和棕色山丘上,前景有风格化的灌木和树木。天空是大片的纹理纸张,有几朵手绘的、蓬松的棕色云朵)。 颜色与线条 (Color & Line): Muted and earthy color palette (terracotta, olive green, muted gold, off-white). All elements have irregular, dark brown ink lines with some stippling and cross-hatching textures.(柔和的泥土色调调色板:赤陶土、橄榄绿、柔和金、米白。所有元素都有不规则的深棕色墨水线条,带有一些点画和交叉影线纹理)。强调了非纯黑线条和低饱和度色彩。 特殊细节 (Special Details): Small radiating light lines emanate from the tops of the Colosseum and the Taj Mahal.(斗兽场和泰姬陵顶部散发出小的放射状光线)。 氛围与质量 (Atmosphere & Quality): Nostalgic, educational, handcrafted travel poster aesthetic, intricate detail, high resolution, vector illustration style with organic textures.(怀旧、教育性、手工制作的旅游海报美学,复杂的细节,高分辨率,带有有机纹理的矢量插画风格)。负面提示词建议 为了确保风格纯正,建议在 Draw Things 的负面提示词中添加以下内容,以防止 AI 生成过于现代或逼真的效果:photorealistic, 3d render, clean lines, modern, digital art, bright colors, glossy texture, sharp edges, gradients, vector clean, photo, painting (照片级真实感,3D 渲染,干净线条,现代,数字艺术,亮色,光滑纹理,锐利边缘,渐变,矢量洁净,照片,绘画)进阶玩法:替换主题 如果你想用同样的风格生成其他主题,比如「中国地标插画」,只需要替换 Subject Matter 部分: A world landmark collage panorama featuring, from left: a section of the Forbidden City in Beijing, the Shanghai Oriental Pearl Tower, a traditional Chinese pagoda, the Potala Palace in Tibet, and the Terracotta Warriors. The color palette is muted and earthy: vermillion red, ink black, jade green, and rice paper white.其他部分(风格、纸张、线条)保持不变,就能得到一张风格一致的中国地标插画。为什么我开始关注本地 AI 创作? 更重要的一点: 它没有次数限制。 不用考虑每个月几十美元的订阅费用,也不用担心自己的创作数据上传到云端。 当然,本地部署也有明显缺点: 比如需要一定硬件配置,模型下载需要几十 GB 空间,生成速度也没有云端 GPU 那么快。 但是我觉得这可能是未来一个重要趋势: 云端 AI 负责极致效果,本地 AI 负责自由创造。 未来每个人可能都会拥有一个属于自己的 AI 工作站。 它了解你的审美、你的工作习惯、你的创作方向。 本地 vs 云端:创作工具的两种哲学维度 云端 AI(Midjourney / 即梦) 本地 AI(Draw Things)使用成本 每月 $10-$60 订阅 完全免费硬件要求 任何能上网的设备 需要较强的 GPU/统一内存生成速度 5-15 秒 30 秒-几分钟次数限制 有 无限制数据隐私 提示词和图片会上传 完全本地商用授权 取决于订阅档位 Flux 等开源模型可商用模型可定制 不可 可加载 LoRA、ControlNet 等后面还想尝试的方向 这次只是简单测试了一下 Flux 2.0 的插画能力,后面还会继续尝试:本地 AI 图片工作流:结合 ControlNet、IP-Adapter 实现更精准的控制 AI 视频生成:Wan 2.2、HunyuanVideo 等本地视频模型的部署 AI 声音克隆:用 Fish Speech / CosyVoice 搭建自己的语音工作站 AI Agent 自动化创作:让 AI 帮我们调度模型、批处理图片、自动发布AI 时代真正有价值的能力,可能不是会不会使用某一个工具,而是能不能搭建属于自己的 AI 生产系统。资源链接Draw Things 官网:https://drawthings.ai Draw Things GitHub:https://github.com/drawthingsai/drawthings Flux 模型(Black Forest Labs):https://blackforestlabs.ai Hugging Face 模型下载:https://huggingface.co/black-forest-labs推荐配置:Apple Silicon Mac(M1 Pro 或更高)、16GB+ 统一内存、50GB+ 可用存储。
- Brody
- 2026/06/26
Ideogram 4 正式开源:不输 GPT-Image 与 Midjourney 的 9.3B 图像模型,支持本地部署!
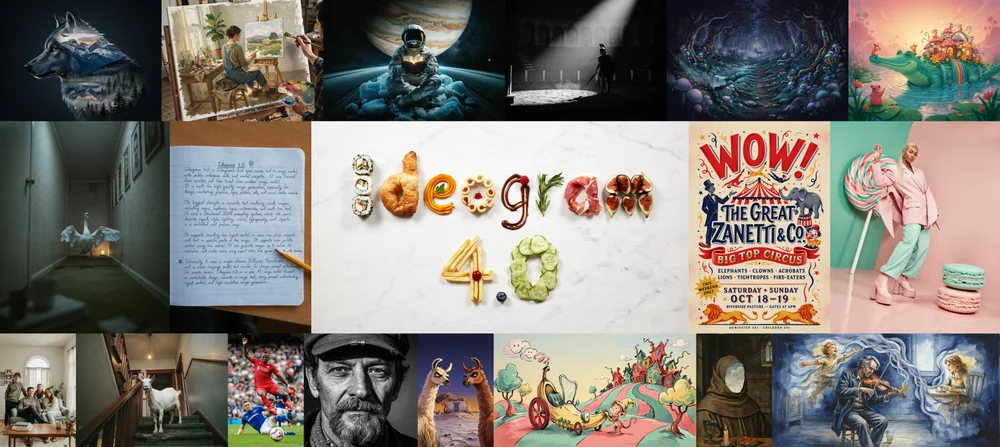
开源图像生成的「GPT 时刻」 2026 年 6 月 3 日,AI 图像生成公司 Ideogram 悄悄做了一个大动作:将旗下旗舰模型 Ideogram 4 的权重全面开源。 这不是一次常规的社区炒作。这是当前开源图像生成领域实力最强的模型——在多个第三方评测中,它不仅是所有开源模型中的第一名,而且在实际盲测中仅次于闭源的 GPT Image 2,把 Flux、Stable Diffusion、Hunyuan 等当红开源模型远远甩在身后。 简而言之:你用本地 GPU 跑出来的图,质量已经和顶级闭源服务不相上下了。Ideogram 4 是什么 Ideogram 是一家由前 Google Brain 研究员创立的 AI 图像公司,此前以精准的文字渲染(Text-in-Image)能力在设计师群体中积累了口碑。Ideogram 4 是他们的 首个开放权重模型——从头训练的基础模型,而非任何现有模型的微调。 几个关键数字:指标 数值参数量 9.3B架构 流匹配 Diffusion Transformer(DiT)文本编码器 Qwen3-VL-8B-Instruct最大原生分辨率 2048 × 2048宽高比范围 最高 6:1量化版本 nf4(CUDA)、fp8(全平台)许可证 非商业许可(商业需联系授权)推理代码许可 Apache 2.0六大核心能力拆解 1. 原生 2K 分辨率生成 大多数开源图像模型(如 SDXL、Flux)原生只能生成 1024×1024,要上 2K 必须依赖超分辨率后处理。Ideogram 4 直接原生支持 256–2048 的任意分辨率(16 的倍数),宽高比最高支持 6:1。 这意味着从方形缩略图到超宽横幅,一套权重全搞定——噪声调度会根据分辨率自动调整。 2. JSON 结构化提示词 这是 Ideogram 4 最独特的创新。模型完全在结构化 JSON 标注上训练,你可以用 JSON 精确控制:调色板:通过 colour_palette 数组指定十六进制颜色,每张图最多 16 个颜色 边界框布局:通过 bbox 坐标(y_min, x_min, y_max, x_max)精确放置主体和文字 空间组合:通过 compositional_deconstruction 逐元素描述每个对象的位置、大小、外观这对于 UI 原型设计、海报排版、数据可视化等需要精确控制的场景,价值巨大——AI 生图从「抽卡」变成了「编程」。 不想手写 JSON?Ideogram 提供了 Magic Prompt API(免费),自动将自然语言提示词转换为结构化 JSON。 3. 最强文字渲染 AI 生图中的「文字」一直是老大难问题。Ideogram 4 在这方面做到了开源最强:在 X-Omni OCR 英文准确率评测中,取得 0.97 的高分 以 9.3B 参数,领先 Qwen-Image(20B)、FLUX.2 dev(32B)、HunyuanImage 3.0(80B MoE)等参数量大得多的模型 支持多行文字、Logo、标语、水印的高保真生成在 ContraLabs 由 10 位专业设计师进行的盲测中,Ideogram 4 的排版能力以 47.9% 的第一名胜率大幅领先 Nano Banana 2(30.0%)、FLUX.2 [max](15.5%)和 Grok Imagine 1.0(15.0%)。 4. 极致参数效率 9.3B 的参数,在如今动辄 30B、80B 的图像模型里不算大。但 Ideogram 4 的评测结果表明——架构设计比堆参数重要得多。它在文本渲染、布局控制等核心维度上超越了参数量数倍于它的对手。 5. 全面可控性 除了 JSON 提示词,Ideogram 4 还支持:色彩调色板条件控制:直接指定主色调 非对称分类器自由引导:条件分支和无条件分支可独立优化,分别控制提示词遵循度和图像质量 多采样预设:V4_QUALITY_48(最高质量 48 步)、V4_DEFAULT_20、V4_TURBO_126. 安全审核集成 内置 Hive 文本和视觉内容审核,支持在推理时自动过滤不安全内容。技术架构:为什么 DiT + VLM 是正确答案 Ideogram 4 的架构有三个值得关注的设计决策: 全单流 DiT 文本和图像 token 拼接为统一序列,通过同一个 34 层 Transformer 处理——没有独立的文本分支或图像分支。这意味着每一层都能进行跨模态交互,而非在某个融合层才「见面」。 视觉语言模型做文本编码器 大多数图像模型用 CLIP 或 T5 做文本编码器,Ideogram 4 用的是 Qwen3-VL-8B-Instruct——一个完整的视觉语言模型。 更关键的是,它不从最后一层取隐藏状态,而是从 13 个中间层分别提取并拼接。这给了 DiT 多尺度的语义特征:浅层提供表面级 token 信息,深层提供组合性理解。 流匹配范式 使用 Flow Matching 替代传统扩散过程,用 Euler 采样器在 logit-normal 噪声调度上积分。相比 DDPM/DDIM,训练效率更高,推理质量也更好。横向对比:Ideogram 4 到底有多强 Design Arena(设计竞技场) 在 Design Arena 整体排行榜中:开源模型第一,以显著优势领先第二名 仅落后于 GPT 和 Gemini 两个闭源模型 在开源模型中以「断崖式」领先ContraLabs 专业设计师盲测 10 位顶级设计师盲测排版能力,Ideogram 4 在两项核心指标上全部第一:模型 第一名胜率 实际可用性(/5)Ideogram 4 47.9% 3.55Gemini 3.1 Flash 30.0% 2.84FLUX.2 [max] 15.5% 2.49Grok Imagine 1.0 15.0% 2.61Ideogram 内部评测 由专业平面设计师盲测,Bradley-Terry 评分:总排名第二,仅次于 GPT Image 2 medium 开源模型排名第一开源基准测试基准 测试能力 Ideogram 4 表现7Bench 布局控制 显著优于所有闭源模型SpatialGenEval 空间推理 接近领先闭源模型X-Omni OCR 文字渲染 最佳开源模型(0.97)Prism 提示词对齐 接近领先闭源模型一句话总结 如果说之前的开源图像模型是在「追赶」,Ideogram 4 就是在「并跑」。尤其是在设计和排版场景下,它几乎追平了闭源最强模型。本地部署指南 硬件要求量化版本 所需显存 支持平台nf4 ~13GB(双 UNet + CLIP GGUF) 仅 CUDA(NVIDIA GPU)fp8 更高 全平台最低配置推荐:16GB 显存的 NVIDIA GPU(如 RTX 4080、RTX 5070)。 步骤一:获取模型权重 模型权重在 Hugging Face 上设有访问门控,需要两步:访问模型页面,点击 「Agree and access repository」 接受许可协议nf4 版本:ideogram-ai/ideogram-4-nf4 fp8 版本:ideogram-ai/ideogram-4-fp8创建 Hugging Face 访问令牌并登录:hf auth login # 或直接导出 export HF_TOKEN="hf_..."步骤二:安装推理代码 git clone https://github.com/ideogram-oss/ideogram4 cd ideogram4 pip install .步骤三:获取 Magic Prompt API Key(免费) Magic Prompt 自动将自然语言转换为 JSON 提示词,注册即用: https://developer.ideogram.ai/ export IDEOGRAM_API_KEY="your_key_here"步骤四:运行推理 python run_inference.py \ --prompt "a ginger cat wearing a tiny wizard hat reading a spellbook" \ --output out.png \ --quantization "nf4" \ --magic-prompt-key "$IDEOGRAM_API_KEY"最高质量模式(原生 2K): python run_inference.py \ --prompt "..." \ --output out.png \ --quantization "nf4" \ --height 2048 \ --width 2048 \ --sampler-preset V4_QUALITY_48ComfyUI 集成(社区方案) ComfyUI 已实现 Day 0 支持,需要升级到 v0.24.0+。 安装配置在 ComfyUI 模板库中,找到 「Ideogram v4(滑滑板图标)」的本地运行模板(注意:还有一个是调用在线 API 的,不要选错)模型下载地址:modelscope.cn/models/Comfy-Org/Ideogram-4社区踩坑经验 来自知乎用户的实际测试反馈:双 UNet 结构:正面条件和负面条件各需要一个 UNet,即使用 nf4 量化也要 ~11GB CLIP 编码器很大:Qwen3-VL-8B 又是一个 ~11GB,建议用 GGUF 量化版本(unsloth/Qwen3-VL-8B-Instruct-GGUF) CFG 参数注意:CFG Override 的 start_percent 应设为 0.7,K Sampler 用 euler 最省显存方案:两个 UNet 都用 nf4,CLIP 用 GGUF,峰值显存约 13GB+ bbox 坐标格式:注意是 [y_min, x_min, y_max, x_max],而非常见的 [x, y, w, h]16GB 显存用户的一个痛点是每次改提示词都要重新加载 CLIP,机械硬盘用户出 1M 图要一分钟以上。强烈建议上 SSD。JSON 提示词实战 不想手写 JSON?用大模型生成。以下是社区验证有效的提示词模板(将最后一句替换为你的需求): Please act as a scene composition assistant. Given my request for an image, you must output a single JSON document that describes the scene in a structured, render-ready form. Output JSON only — no prose, no markdown fences, no commentary.Your response MUST be a single valid JSON object matching exactly this shape:{ "high_level_description": "...", "style_description": { "aesthetics": "...", "lighting": "...", "photo": "...", "medium": "...", "color_palette": ["#XXXXXX", "#XXXXXX"] }, "compositional_deconstruction": { "background": "...", "elements": [ { "type": "obj", "bbox": [y_min, x_min, y_max, x_max], "desc": "...", "color_palette": ["#XXXXXX"] } ] } }Hard constraints: - bbox coordinates: [y_min, x_min, y_max, x_max] on a 1000×1000 canvas - All keys are required. Output valid JSON and nothing else.Now, generate the JSON based on my image request: [你的绘画需求]用 Gemini Flash 或 GPT-4o 来生成 JSON 提示词,效果最好。写在最后:开源图像模型的转折点 Ideogram 4 的开源有几个信号值得关注:开源不再等于「够用就行」。它在设计和排版场景下已经逼近甚至超越闭源最强模型,这对 Midjourney、DALL·E 构成真实压力。架构创新比参数量重要。9.3B 的模型在多个维度上碾压 30B、80B 的对手——单流 DiT + VLM 编码器 + JSON 结构化训练的组合拳,可能是下一代图像模型的标配。本地部署的体验门槛在降低。nf4 量化 + GGUF CLIP 编码器已经能在 16GB 消费级显卡上跑,虽然速度不如云端服务,但对于追求隐私和可控性的用户,这是一个真正的选择。「可编程生图」是新方向。JSON 提示词看似增加了使用门槛,但它将 AI 生图从「描述性」推向了「精确控制」,打开了 UI 原型、排版设计、数据可视化等严肃应用场景的大门。最后也说一句实话:如果你只是偶尔生成几张图玩,直接用 ideogram.ai 的在线服务就够了。但如果你需要精确控制、本地隐私、批量生成,或者你想在自己的产品中集成图像生成能力——Ideogram 4 可能是当下最好的开源选择。